LLM — это языковая модель, программа, которая продолжает текст: вы пишете начало, она подбирает самое правдоподобное продолжение. Именно так устроены чат-ассистенты вроде тех, к которым вы привыкли. Мы поставили четыре такие модели на обычный VPS с 2 ядрами и 4 ГБ памяти без видеокарты и посмотрели, что из этого выходит: сколько они занимают, как быстро отвечают и, главное, как часто ошибаются. Одна из моделей на сервер просто не влезла.
Что такое LLM простыми словами
Представьте телефонную клавиатуру, которая подсказывает следующее слово. Теперь представьте, что она прочитала миллионы страниц текста и подсказывает не слово, а целые абзацы. Это и есть LLM. Она не ищет ответ в базе и не «знает» страны и годы: она выбирает продолжение, которое чаще всего встречалось в похожих текстах.
Отсюда главное свойство, которое надо понимать до всего остального: правдоподобный ответ и верный ответ — не одно и то же. Модель может написать гладко и уверенно, и при этом ошибиться. Ниже вы увидите это на реальных примерах.
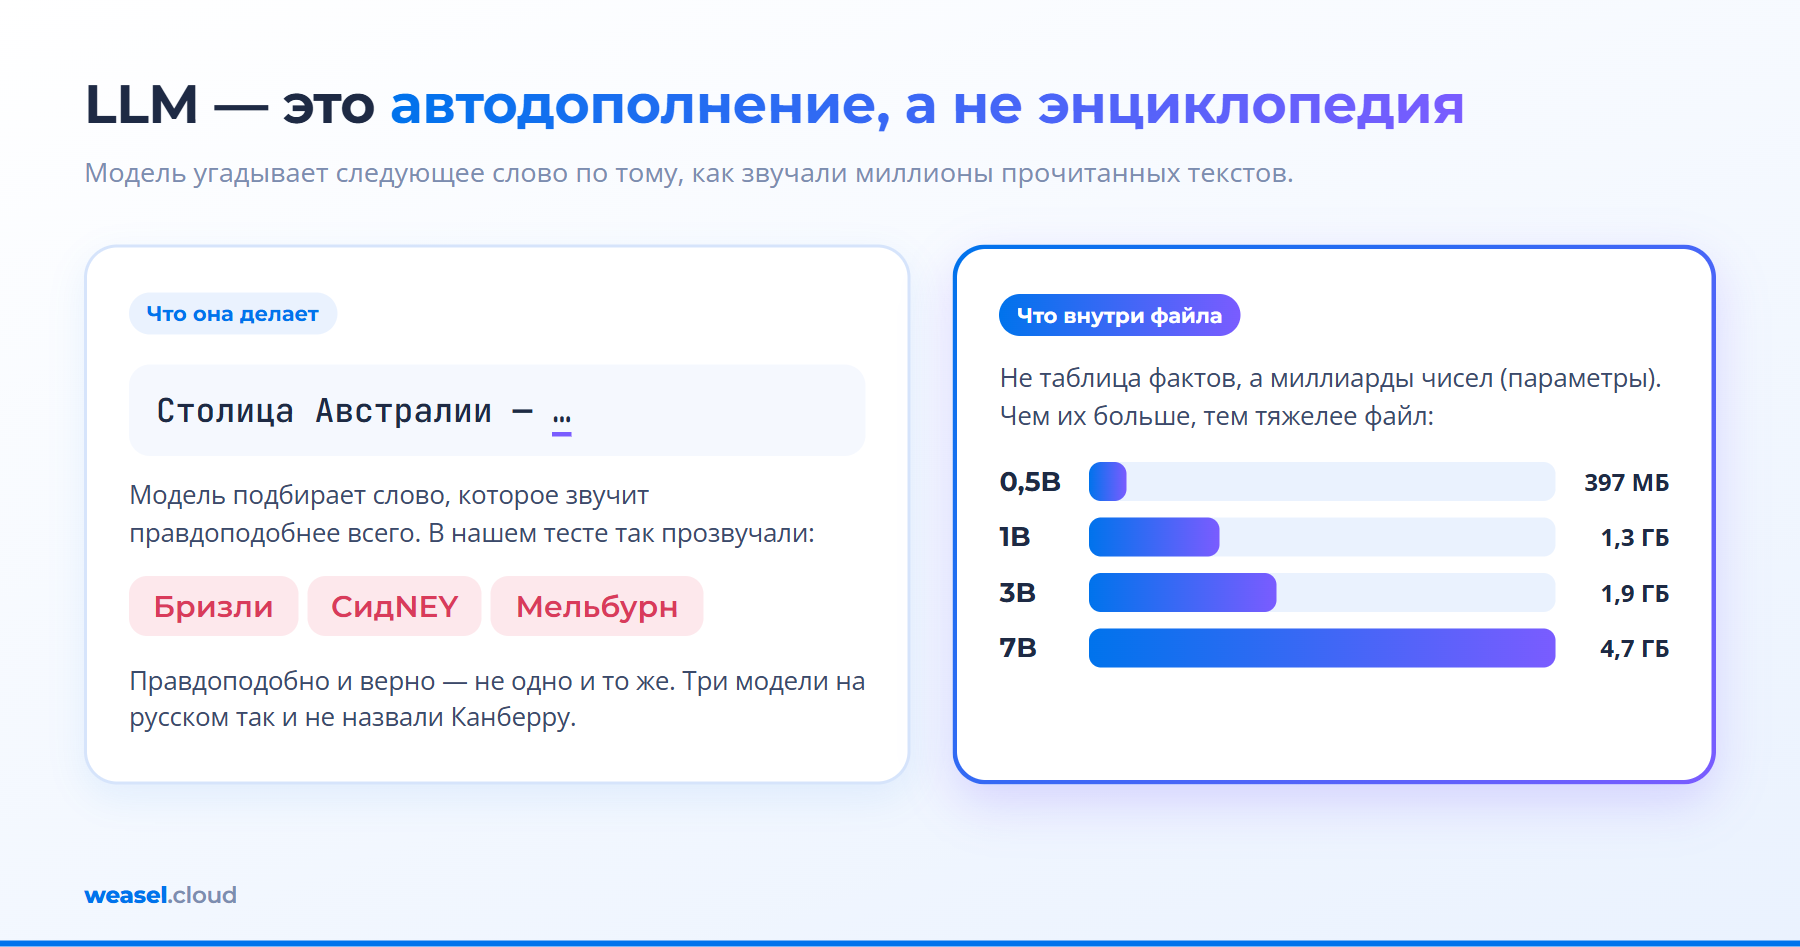
Два слова, которые будут встречаться дальше. Параметры — числа внутри модели, в которых «записано» всё, чему она научилась. Их считают миллиардами: «3B» значит примерно 3 млрд. Чем параметров больше, тем тяжелее файл и тем больше памяти нужно. Токен — кусок слова, с которым модель работает; скорость её ответа меряют в токенах в секунду.
Что нужно, чтобы запустить LLM на своём сервере
Три ресурса, и важны они по-разному.
- Память — главное. Модель целиком загружается в оперативную память. Не хватило памяти — ядро Linux убивает процесс, и ответа не будет вообще. Это не «станет медленнее», а «не заработает».
- Процессор определяет скорость. Без видеокарты считает центральный процессор, и чем больше модель, тем медленнее текст появляется на экране.
- Диск — только место под файлы. Модели лежат на диске и читаются при загрузке. Скорость диска влияет на старт, но не на ответ.
Простая оценка памяти по нашему замеру: модель занимает примерно столько, сколько весит её файл (у нас разница не больше 0,1 ГБ), а сама система в покое занимала 0,4-0,6 ГБ. Плюс запас под текст разговора: чем длиннее запрос, тем память вырастает больше.
Опыт: четыре модели на VPS с 2 ядрами и 4 ГБ
Мы взяли VPS Weasel с 2 vCPU, 3,9 ГБ памяти и Ubuntu 24.04, без видеокарты. Ollama — программа, которая скачивает модели и запускает их, — ставится одной командой. Установщик сам предупредил, что видеокарты нет, и работать всё будет на процессоре:
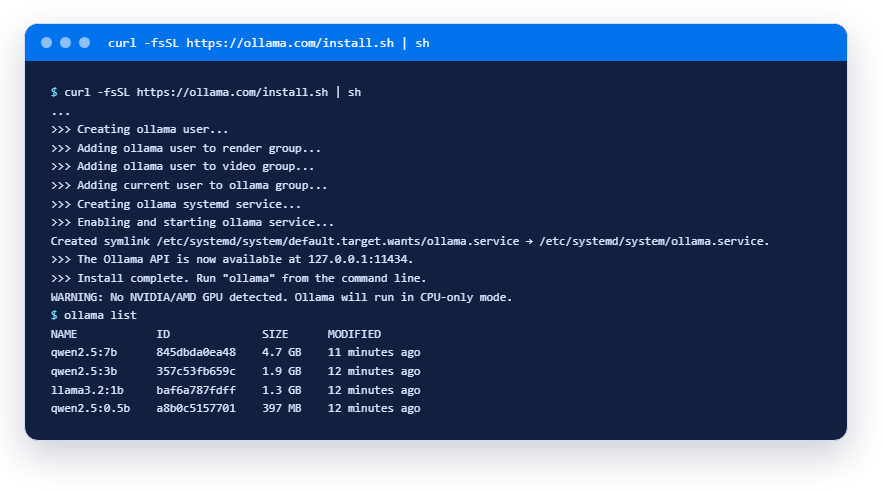
Мы скачали четыре модели разного размера: от 0,5 до 7 млрд параметров. Для каждой запускали один и тот же набор вопросов и смотрели, сколько занимает памяти и сколько токенов в секунду выдаёт:
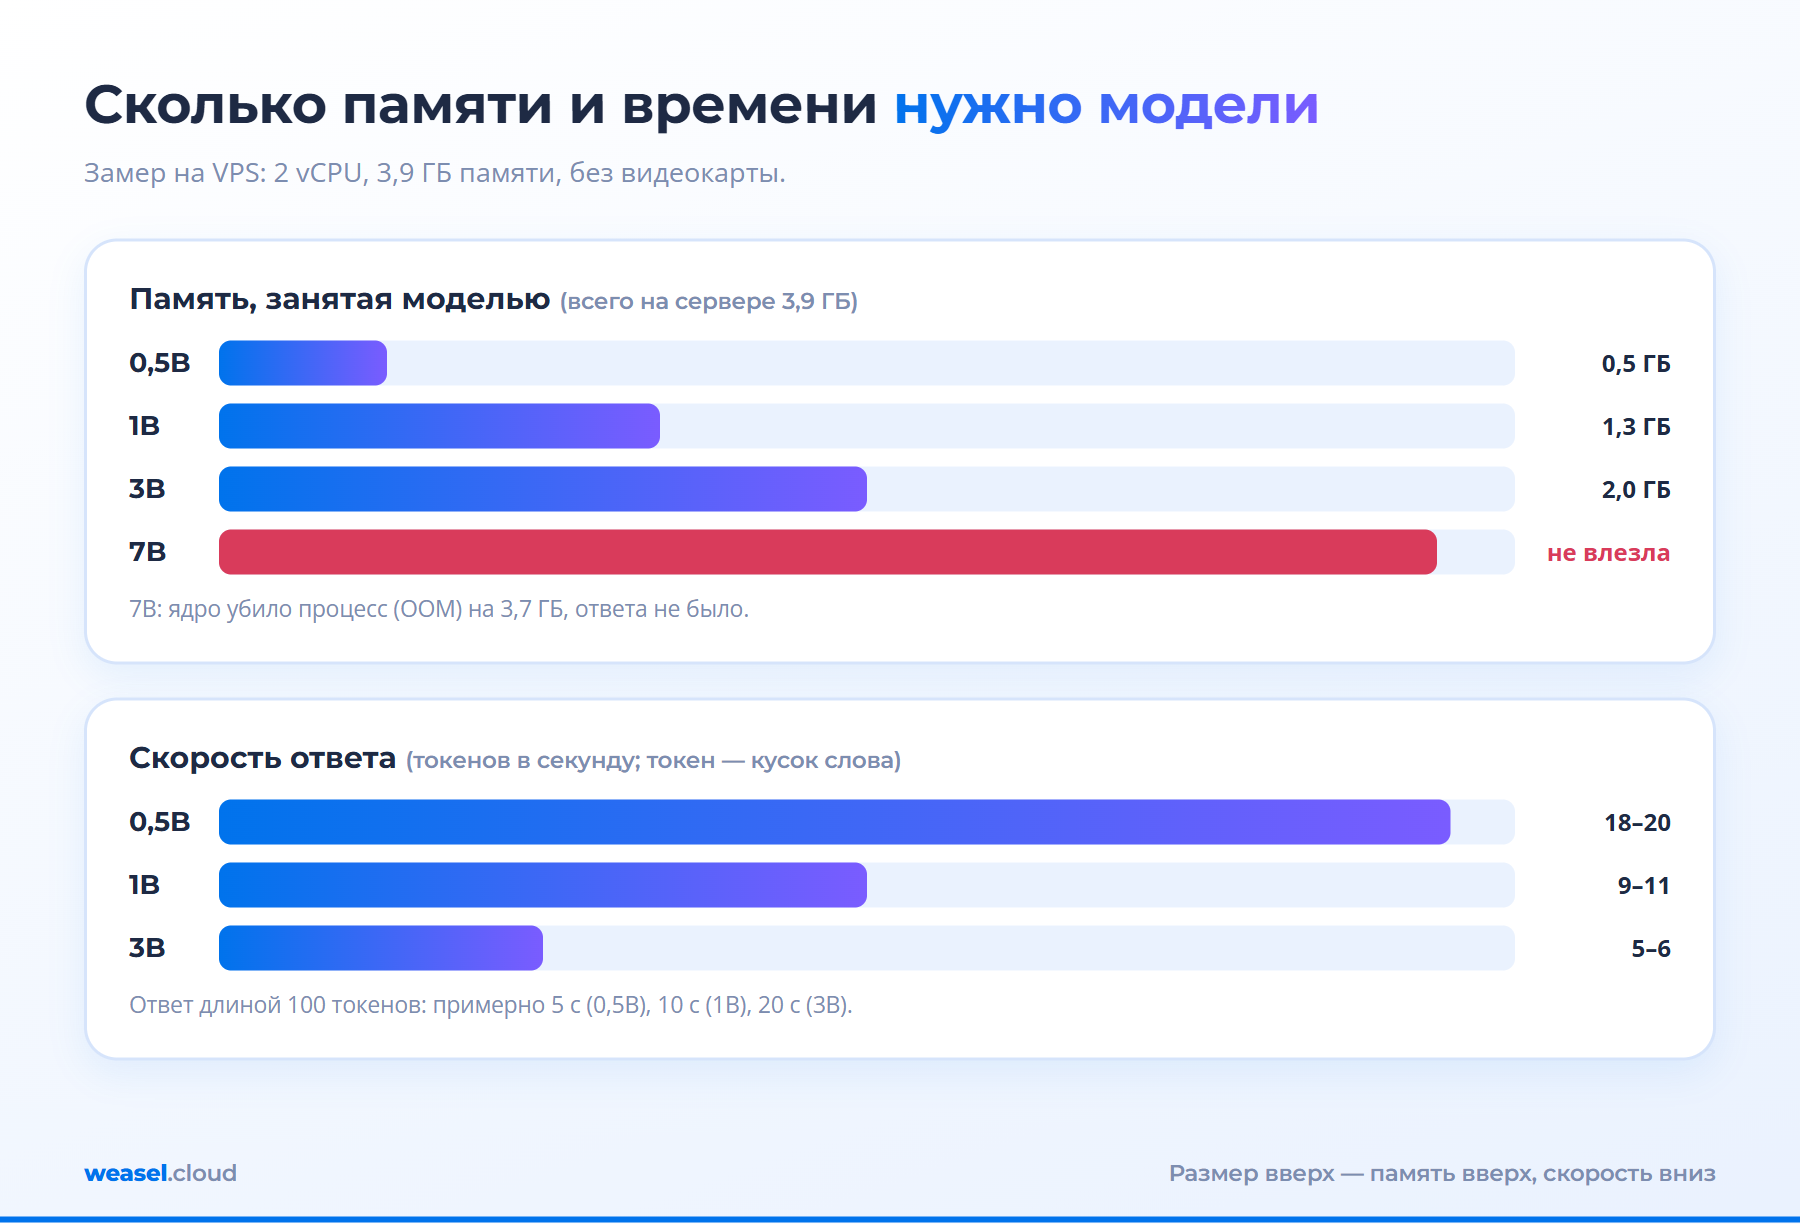
Рост предсказуемый: больше модель — больше памяти и ниже скорость. Скорость падает примерно вдвое при каждом шаге: 18-20 токенов в секунду у 0,5B, 9-11 у 1B, 5-6 у 3B. Ответ в сотню токенов у самой маленькой занимает около 5 секунд, у 3B — около 20.
Модель на 7 млрд не влезла
Файл модели на 7 млрд параметров весит 4,7 ГБ, а памяти на сервере 3,9 ГБ. Мы всё равно попробовали. Результат:
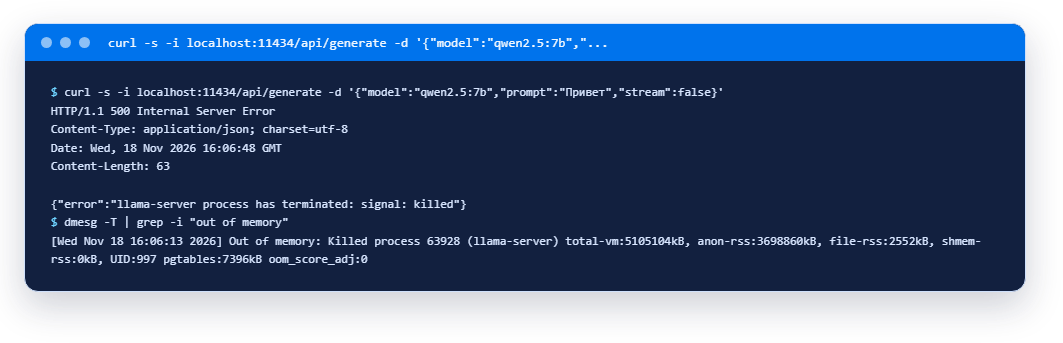
Ответа нет: сервер вернул ошибку 500, а в системном журнале запись о том, что ядро убило процесс модели, когда он занял 3,7 ГБ. Это то самое «не хватило памяти — не заработало». Правило такое: файл модели должен помещаться в оперативную память с запасом. Для файла в 4,7 ГБ берите сервер с запасом: 8 ГБ и больше.
Что модели ответили: ошибаются все
Каждой модели мы задали пять вопросов по-русски. Три — на память («столица Австралии», «сколько 17 × 23», «что такое swap в Linux»). Два — задачи, где ответ лежит в самом запросе: короткое письмо про время встречи и пять строк лога веб-сервера, где надо найти адрес с наибольшим числом ответов 404.
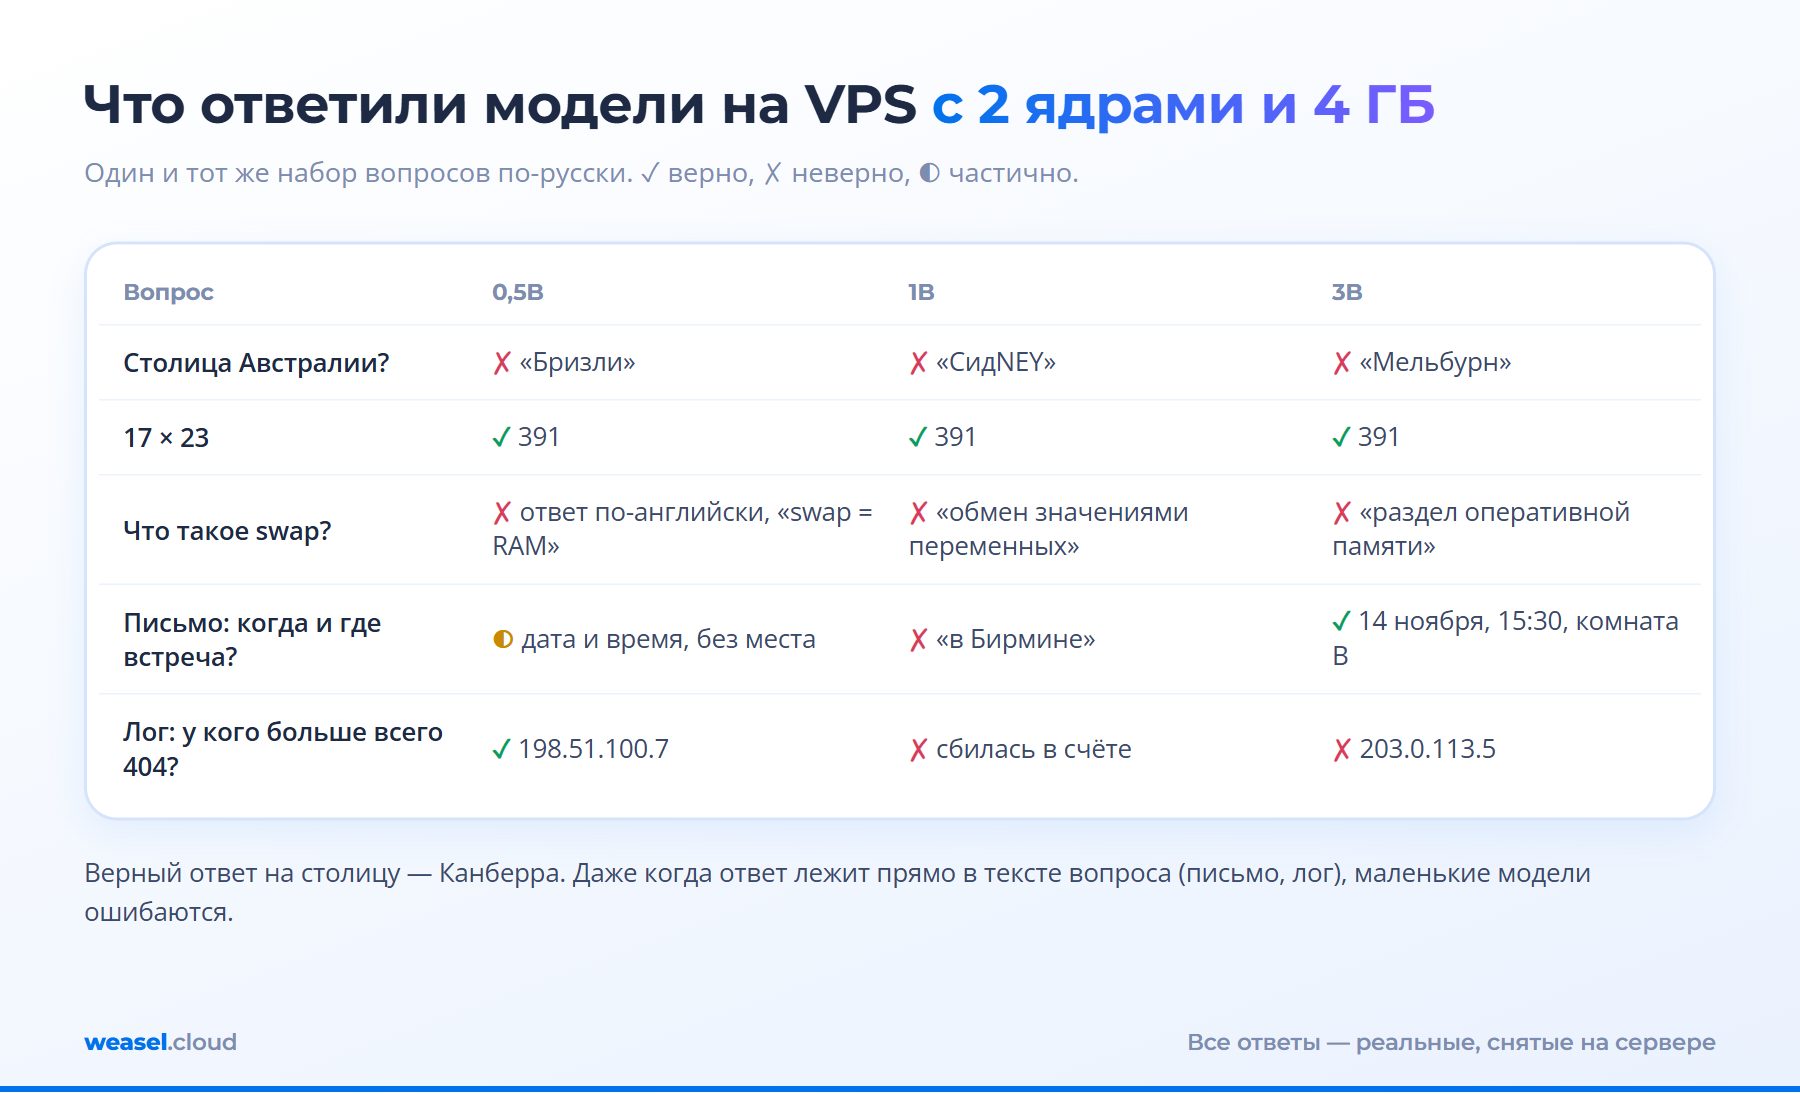
Что здесь видно.
- Факты из памяти ненадёжны. Канберру не назвала ни одна модель. А модель на 3 млрд параметров ещё и зациклилась: «Столицей Австралии является город Мельбурн. Однако это неверно. Столицей Австралии является город Мельбурн». Про swap все три модели ответили неверно: swap — это место на диске, а не «раздел оперативной памяти» и тем более не «обмен значениями переменных».
- Арифметика получилась у всех. 17 × 23 = 391 назвали все три. Но это единственный вопрос, где ответ верный у каждой.
- Размер не гарантирует качество. Задачу с логом верно решила самая маленькая модель (198.51.100.7), а самая большая из запущенных назвала не тот адрес. Адрес 198.51.100.7 получил два ответа 404, адрес 203.0.113.5 — один. Модель на 1 млрд параметров письмо про встречу и вовсе «перенесла» в выдуманный город.
- Язык влияет. Мы повторили тот же набор по-английски. Все три модели назвали Канберру (самая маленькая добавила неверную подробность, что это «крупнейший город»), письмо прочитали верно. Если ваши тексты на русском, проверяйте модель именно на русском.
Для чего такая модель годится
Не как энциклопедия. А вот для работы с текстом, который вы ей даёте, при условии что результат вы потом проверяете:
- сортировка и пометка входящих писем и обращений;
- краткая выжимка длинного текста, из которой вы решаете, читать ли оригинал;
- черновики ответов, которые вы правите перед отправкой;
- вытаскивание из текста дат, имён, сумм в таблицу (с выборочной проверкой).
Обычно такие задачи лучше удаются моделям покрупнее и на коротких текстах, но не всегда: в нашем русском тесте лог решила самая маленькая модель, а 3B ошиблась. Поэтому для каждой задачи нужна проверка: мы только что видели, как модель «читает» письмо и выдумывает город.
Нужен ли вам свой VPS для LLM
Свой сервер — не про «умнее», а про контроль. Он выигрывает в трёх случаях: тексты нельзя отправлять внешнему сервису (договоры, переписка с клиентами, внутренние инструкции); задачи простые и повторяются; нужен собственный адрес, по которому скрипты и боты обращаются к модели. Проигрывает он там, где нужны сильный русский язык, точные факты и скорость как в чате: на 2 ядрах ответ приходит за секунды или минуты, а не мгновенно.
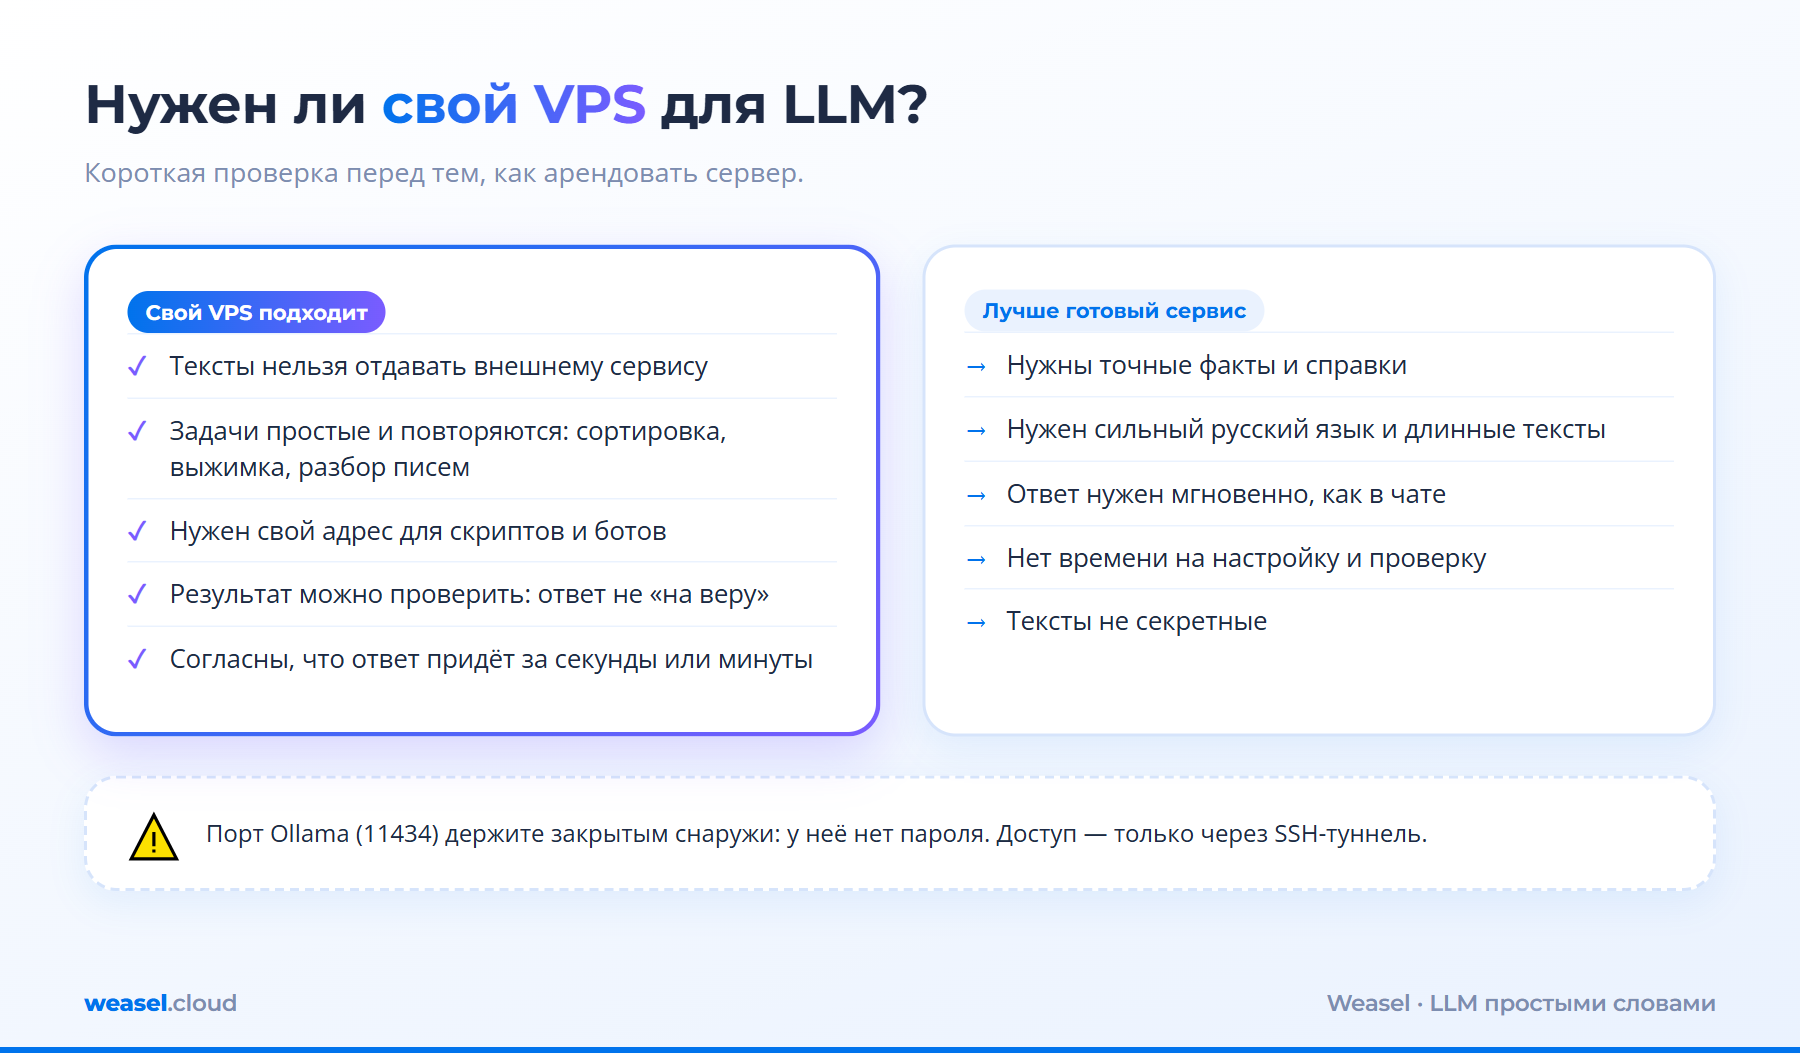
Если решили пробовать: начните с модели на 1-3 млрд параметров и сервера с 4 ГБ памяти, как у нас. Если 1B не справляется, пробуйте 3B, хотя качество она не гарантирует; всё, что больше 3B, требует 8 ГБ и выше. И заранее решите, как вы будете проверять ответы: без проверки такая модель ошибётся незаметно.
Безопасность: закройте порт
У Ollama нет пароля. Она слушает адрес 127.0.0.1:11434, то есть доступна только с самого сервера. Так и оставьте. Если нужен доступ с другого компьютера, пробросьте порт через SSH-туннель, а не открывайте его наружу: иначе чужие смогут гонять вашу модель на вашем процессоре.
Частые вопросы
Хватит ли VPS с 1 ГБ памяти?
По нашим цифрам, самая маленькая модель (0,5B) вместе с системой занимает около 1 ГБ, так что на сервере с 1 ГБ запаса не останется. Мы так не проверяли. Для 1B и больше берите минимум 4 ГБ.
Нужна ли видеокарта?
Нет, наш замер сделан без неё: Ollama сама переключилась на процессор. Видеокарта ускоряет ответ, но на обычном VPS её нет, и маленькие модели без неё работают.
Можно ли «научить» модель на своих документах?
Дообучать модель на VPS без видеокарты непрактично. Чаще достаточно другого приёма: находить в ваших документах нужные куски и подкладывать их модели в запрос. Он называется поиск с генерацией (RAG) и подходит и для небольшого сервера.
Какую модель выбрать для русского языка?
Универсального ответа у нас нет: мы проверили три небольшие модели на пяти вопросах, и это не рейтинг. Возьмите 2-3 модели подходящего размера и прогоните на своих типичных вопросах: результаты заметно отличаются от задачи к задаче.
Что запомнить
- LLM подбирает правдоподобное продолжение текста, а не ищет факты. Ошибается уверенно.
- Главный ресурс — память: модель должна помещаться в оперативную память с запасом, иначе ядро убьёт процесс.
- На VPS с 2 ядрами и 4 ГБ работают модели до 3 млрд параметров, со скоростью от 5 до 20 токенов в секунду.
- Для справок и точных фактов берите готовый сервис. Свой сервер оправдан приватностью и простыми повторяющимися задачами.
- Результат всегда проверяйте, а порт Ollama держите закрытым.
Читайте также
Сеть9 ноября 2026 г.
Какую страну сервера выбрать для ИИ: ChatGPT, Claude, Gemini и API
Ресурсы6 ноября 2026 г.
Что такое VPS: простыми словами, как устроен виртуальный сервер и зачем он нужен
Сеть4 ноября 2026 г.
Что такое DNS-сервер: как работает DNS, как его проверить и что делать, если он не отвечает
Сервер за 1 минуту
Выберите локацию и тариф в личном кабинете. Сервер подключается автоматически после оплаты.